一句話怎麼變成回答
- 偵測說話Silero VAD 判斷你什麼時候開始、什麼時候說完
- 聽寫Whisper 把語音轉成文字
- 思考本機的 Qwen 對話模型產生回答
- 說話語音合成唸出回答,播完自動繼續聽
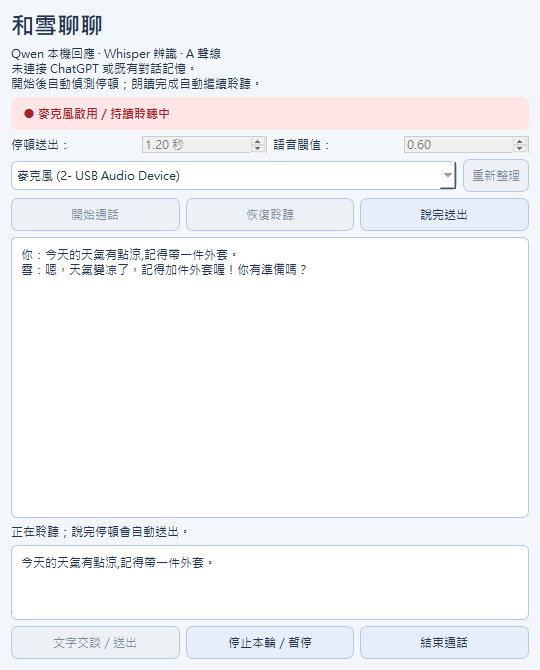
做到的事
- 連續對話:說完停頓 1.2 秒自動送出,回答播完自動開始聽下一句。
- 半雙工:它說話時不收音,避免把自己的聲音當成你的話。
- 滾動摘要:對話變長時,自動把前面的內容整理成摘要,保留上下文。
- 可以手動送出、暫停、取消,結束時 2 秒內清理乾淨。
- 啟動時不會自動錄音,也沒有開機自動啟動。
還沒解決的問題
目前最大的問題是慢:測試中每一輪從說完到聽到回答,大約要 100 秒以上。下一步要換更小的模型或更快的推論方式。實體麥克風的實地測試也還沒做。
角色外觀原本想做成 Live2D,評估後發現需要完整的分層原畫和綁定工具,所以先用 2D 圖層的方式實作。
這是實驗,不是產品。這一頁會隨著實驗進度更新。